
Strukturierte Daten
Eine reine RAG-Suche findet Textstellen, kann aber keine Summen, Mengen oder Ranglisten berechnen. Für wiederkehrende Dokumentenarten – Rechnungen, Verträge, Prüfberichte – kann companyRAG deshalb zusätzlich strukturierte Daten aus den Dokumenten extrahieren: Ein Sprachmodell füllt ein von Ihnen definiertes Tabellenschema, das anschließend per SQL abfragbar ist.
Damit stehen für dieselbe Sammlung zwei Zugriffswege bereit, die sich kombinieren lassen: die semantische Suche über den Text und die strukturierte Abfrage über die extrahierten Felder.
Aktivieren Sie die Option Strukturierte Daten extrahieren (Beta) beim Erstellen der Sammlung vom Typ Dokumente. Die Option lässt sich nur beim Erstellen einschalten.
Schema definieren
Abschnitt mit dem Titel „Schema definieren“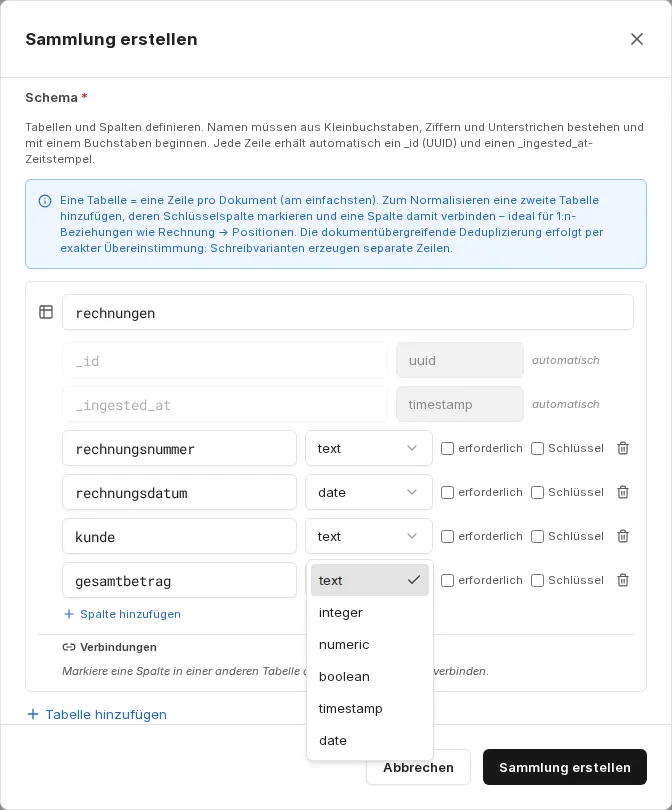
Der einfachste Fall ist eine Tabelle mit einer Zeile pro Dokument. Je Spalte legen Sie Namen und Datentyp fest und markieren optional, ob das Feld erforderlich ist oder als Schlüssel dient.
Verfügbare Datentypen: text, integer, numeric, boolean, timestamp, date.
Namen müssen aus Kleinbuchstaben, Ziffern und Unterstrichen bestehen und mit einem Buchstaben beginnen. Jede Zeile erhält automatisch die Felder _id (UUID) und _ingested_at (Zeitstempel).
Zusätzlich können Sie unter Extraktionsanweisungen (optional) beschreiben, welche Informationen extrahiert werden sollen, und unter Maximale Seitenzahl pro Dokument (optional) die Anzahl der auszuwertenden Seiten begrenzen – etwa auf die ersten fünf Seiten, wenn die relevanten Angaben immer am Anfang stehen. Das reduziert Kosten und Laufzeit.
Die Extraktionsanweisungen können Sie später unter Sammlung bearbeiten anpassen. Die Änderung gilt für Dateien, die ab dann indexiert werden; bereits verarbeitete Dokumente behalten ihre extrahierten Daten. Das Schema selbst ist nach dem Erstellen schreibgeschützt.
Mehrere Tabellen und Beziehungen
Abschnitt mit dem Titel „Mehrere Tabellen und Beziehungen“Für 1:n-Beziehungen – etwa eine Rechnung mit mehreren Positionen – markieren Sie in der ersten Tabelle die Schlüsselspalte (etwa die Rechnungsnummer), fügen eine zweite Tabelle für die Positionen hinzu und verbinden deren passende Spalte mit diesem Schlüssel.
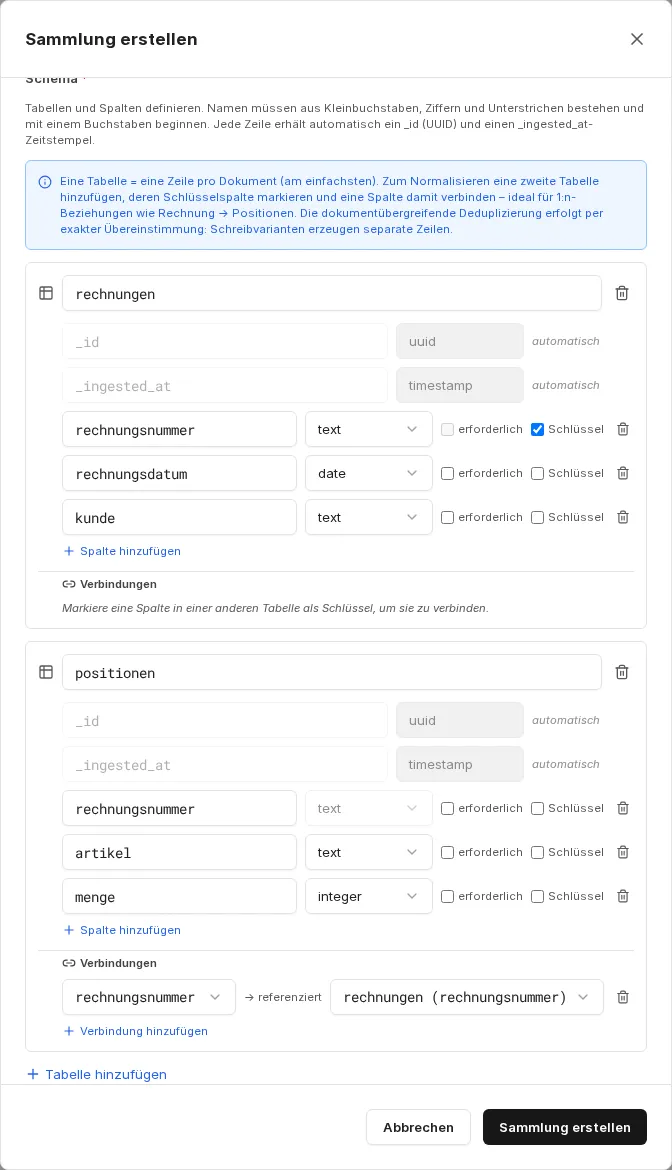
Die Verbindung wird bei Abfragen als JOIN-Hinweis genutzt. Aus einem Dokument entstehen dann mehrere Zeilen in der Positionstabelle, während die Kopfdaten einmalig in der ersten Tabelle liegen.
Status der Extraktion
Abschnitt mit dem Titel „Status der Extraktion“Schlägt die Extraktion für ein Dokument fehl, ist das Dokument trotzdem für die semantische Suche indexiert. Unter Dateien trägt es dann den Status Indexiert (Warnung).
Die extrahierten Tabellen werden über die SQL-Tools des MCP-Servers ai-search abgefragt, genau wie Datensatzsammlungen. Welche Tools ein Agent dafür benötigt, beschreibt companyRAG in CompanyGPT nutzen.